O modelo fantasma que "destruiu" o GPT-5.6 — e a aula de estatística que veio junto
O que apareceu
Em 20 de agosto de 2026, um modelo sem nenhum nome de empresa associado surgiu no OpenRouter sob o identificador stealth/ox-alpha. Ao mesmo tempo, apareceu no OpenCode, agente de código de terminal.
As especificações chamaram atenção sozinhas: 1.048.576 tokens de contexto, até 131 mil tokens de saída por chamada, entrada de texto, imagem e vídeo, suporte nativo a tool calling e saída estruturada em JSON. E grátis por uma semana.
Modelos assim têm nome: stealth models. São modelos colocados em teste público sob nome-fantasia, com o fabricante nunca se apresentando. A prática é legítima e tem lógica — dá para medir preferência real sem o viés de expectativa que uma marca conhecida carrega, e dá para colher uso real antes do lançamento oficial. Também é, convenientemente, marketing gratuito.
O número que viralizou
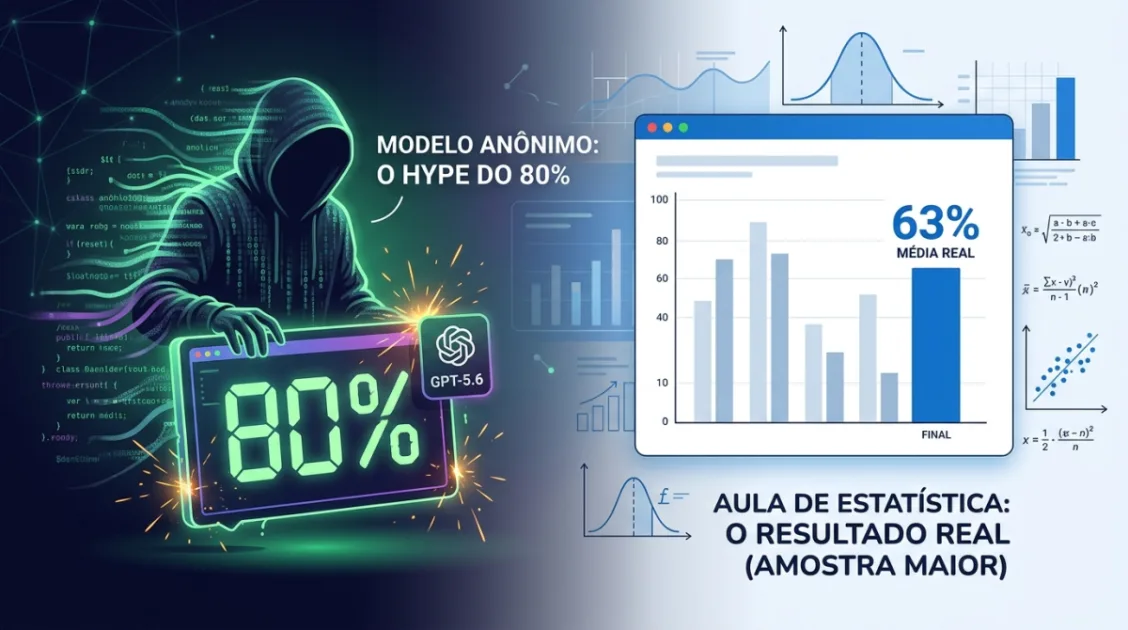
Nos primeiros testes independentes, o Ox Alpha fechou o benchmark de código DeepSWE em 80%, contra 65% do Claude Fable 5 e 52% do GPT-5.6-sol.
Em 24 horas a internet já tinha decidido: modelo misterioso destrói os líderes.
O detalhe que quase ninguém leu
Os 80% vieram de uma amostra inicial de dez tarefas.
Uma avaliação posterior, com um subconjunto maior, produziu aproximadamente 63%.
Dez tarefas. Vamos ser concretos sobre o que isso significa: com n=10, cada acerto ou erro individual move o resultado em dez pontos percentuais inteiros. Oito acertos em dez é estatisticamente compatível com uma taxa real de sucesso em uma faixa larguíssima — algo da ordem de 44% a 97%, dependendo do intervalo que você use.
Traduzindo: aquele 80% não estava medindo o modelo. Estava medindo o sorteio.
O modelo pode ser excelente. O número de 63% em amostra maior continua sendo forte. Mas a manchete que circulou foi construída sobre uma medição que não sustentava nenhuma das comparações que ela fez.
O checklist para não cair no próximo
O Ox Alpha vai ter nome, e daqui a duas semanas outro fantasma aparece. As cinco perguntas que economizam sua semana:
1. Qual o n? Se a fonte não diz quantas tarefas foram avaliadas, o número não é um resultado — é uma anedota com casas decimais.
2. Quem rodou? Avaliação do próprio fabricante, avaliação independente e print de rede social são três coisas diferentes com três níveis de confiança diferentes.
3. O benchmark está no treino? Contaminação de dados é o problema silencioso da área. Benchmark público e conhecido tende, com o tempo, a virar dado de treinamento — e aí a pontuação mede memória, não capacidade.
4. Qual o custo por tarefa resolvida? Percentual bruto esconde economia. Um modelo que resolve 63% por um décimo do preço vence, em produção, um que resolve 70% caro. A métrica de negócio nunca foi a porcentagem.
5. Reproduziu no seu código? Benchmark roda em repositório público, bem documentado, com teste. O seu legado não é assim. A distância entre esses dois mundos é onde as promessas morrem.
O teste que vale mais que qualquer leaderboard
Trinta minutos, uma vez, e você para de depender de manchete para sempre:
- Separe vinte tarefas reais e já fechadas do seu backlog dos últimos três meses — issues que viraram PR de verdade.
- Guarde o PR original como gabarito.
- Rode o modelo candidato em cima das mesmas tarefas, com o mesmo contexto que um dev teria.
- Meça quatro coisas: resolveu de fato, passou no CI, quanto custou e quanto tempo de revisão humana consumiu.
Esse conjunto envelhece bem, serve para o próximo modelo e para o seguinte, e responde a única pergunta que importa: não "qual modelo é o melhor do mundo?", mas "qual modelo é o melhor para o meu código, no meu orçamento?".
A última linha
Benchmark público diz quem está na corrida. Isso tem valor — é o filtro que define quem vale testar.
Mas leaderboard nenhum conhece o seu legado, a sua convenção de nomes, a sua regra fiscal esquisita nem aquele módulo que ninguém entende desde 2019. Só o seu repositório sabe quem realmente trabalha para você. Vinte tarefas reais valem mais que dez mil posts sobre o modelo da semana.
Posts relacionados
A vaga de júnior não sumiu por causa da IA — sumiu porque a rampa de entrada foi automatizada
Vagas de entrada em engenharia caíram 67%, e nas big techs júnior passou de 32% para 7% da...
Você não ficou 4x mais rápido. Ficou 10x mais inseguro — e agora existem os dados
Quase metade do código gerado por IA nasce com uma falha do OWASP Top 10. Os commits saem...
2,4 trilhões de parâmetros em open weights: o modelo de fronteira saiu do data center
Agosto de 2026 empilhou o maior lançamento de open weights da história e um modelo multimo...